Noticias › IA
IA
Musk llama «obra maestra» a Claude Opus 5.5 y admite que Grok 4.8 no lo igualará
Dice que Grok 5 «debería superar» a Opus 5.5 en dos o tres meses; Anthropic informa de un 66,4 % en Terminal-Bench 4.0 frente al 57,9 % de GPT-6 Astra de OpenAI.
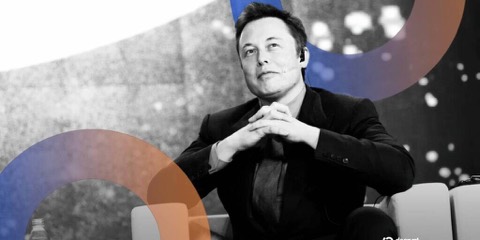
Elon Musk elogió a un modelo rival con un entusiasmo poco habitual y admitió que su próxima versión no podrá superarlo. Preguntado en X cómo se compararía Grok 4.8 con Claude Opus 5.5 de Anthropic, el fundador de xAI respondió que sería «no tan bueno». «Opus 5.5 es una obra maestra», escribió el martes. Añadió que Grok 5, un modelo de nueva generación que llegará después de esta actualización, «debería superar a Opus 5.5», posiblemente en dos o tres meses, aunque no dio más detalles ni una fecha firme, algo habitual en sus plazos.
La conversación empezó con un parte técnico. Musk dijo que Grok 4.8 había terminado el preentrenamiento pero seguía en aprendizaje por refuerzo, la fase en la que las respuestas se refinan con retroalimentación y recompensas, y que el equipo había dedicado mucho tiempo a limpiar los datos de ajuste fino supervisado, los ejemplos con los que se enseña al modelo a seguir instrucciones. También contó que abandonaron JAX, un marco de aprendizaje automático, y SGLang, un software para servir modelos, a favor de un sistema de inferencia y refuerzo reescrito en C y C++. La inferencia es el proceso de generar respuestas cuando el usuario envía una pregunta; reescribir el software de base puede dar más control sobre el rendimiento, pero Musk no aportó cifras de mejora.
Describió Grok 4.8 como «todavía no increíble», aunque dijo que por fin tiene los cimientos bien construidos, y espera un despliegue suave para un grupo de usuarios a finales de esta semana, una prueba temprana antes de una salida más amplia. Grok 4.8 es la actualización inmediata; Grok 5 es el modelo con el que cree que podría adelantar a la competencia, hasta que los rivales saquen otro.
Del lado de Anthropic, Decrypt recuerda que Opus 5.5 salió el 22 de septiembre. Ofrece un rendimiento comparable al de su modelo superior Fable 5.1 en la mayoría de tareas, con un coste un 40 % menor que el de la anterior versión de Opus en cargas típicas, y se orienta a programación difícil y a agentes que resuelven varios pasos con poca supervisión humana. En Terminal-Bench 4.0, que mide si los agentes completan tareas complejas en una línea de comandos, Anthropic informó de un 66,4 % para Opus 5.5 frente al 57,9 % de GPT-6 Astra de OpenAI. Musk no ha publicado resultados de Grok 4.8 que permitan medir la distancia real.
Hay que leer el episodio con cautela. Un elogio público de un competidor es noticia por su rareza, pero no es una medición: las cifras que importan son los resultados independientes y el uso real. Y las promesas de plazos de Musk tienen un historial discutible, como señala el propio medio.
Para quien construye con estas herramientas, lo útil es práctico: el listón de los modelos de programación y agentes sigue subiendo cada pocos meses, y conviene comparar con pruebas propias en lugar de fiarse de la reputación del fabricante o de los comentarios en redes.
Solo hechos, nunca asesoramiento financiero.
Sobre el autor
Juan Cienfuegos
Fundador y CEO de BitCorner Media
Presenta BitCorner, el podcast de Bitcoin desde El Salvador. BitCorner Media es el primer medio de Bitcoin y tecnología de El Salvador y ayuda a empresas de Bitcoin y tecnología a llegar y a formar a la audiencia hispanohablante.